KI-Training blockieren, ohne aus KI-Antworten zu verschwinden
Das gemeinsame KI-Opt-out und seine Folgen für die Sichtbarkeit
Am 30. Oktober 2026 haben OpenAI, Google, Microsoft und Anthropic angekündigt, ein gemeinsames Signal in der robots.txt zu unterstützen. Damit sollen Website-Betreiber ihre Inhalte in einem Schritt bei allen vier Anbietern vom KI-Training ausschließen können, statt für jeden Anbieter einen eigenen Crawler sperren zu müssen. Grundlage ist ein Entwurf bei der IETF, die Umsetzung läuft bis ins Jahr 2027.
Für mehr Kontrolle über die eigenen Inhalte ist das ein Fortschritt. Für die Sichtbarkeit in KI-Antworten birgt es aber eine Falle, die man kennen sollte.
Training und Grounding: zwei verschiedene Dinge
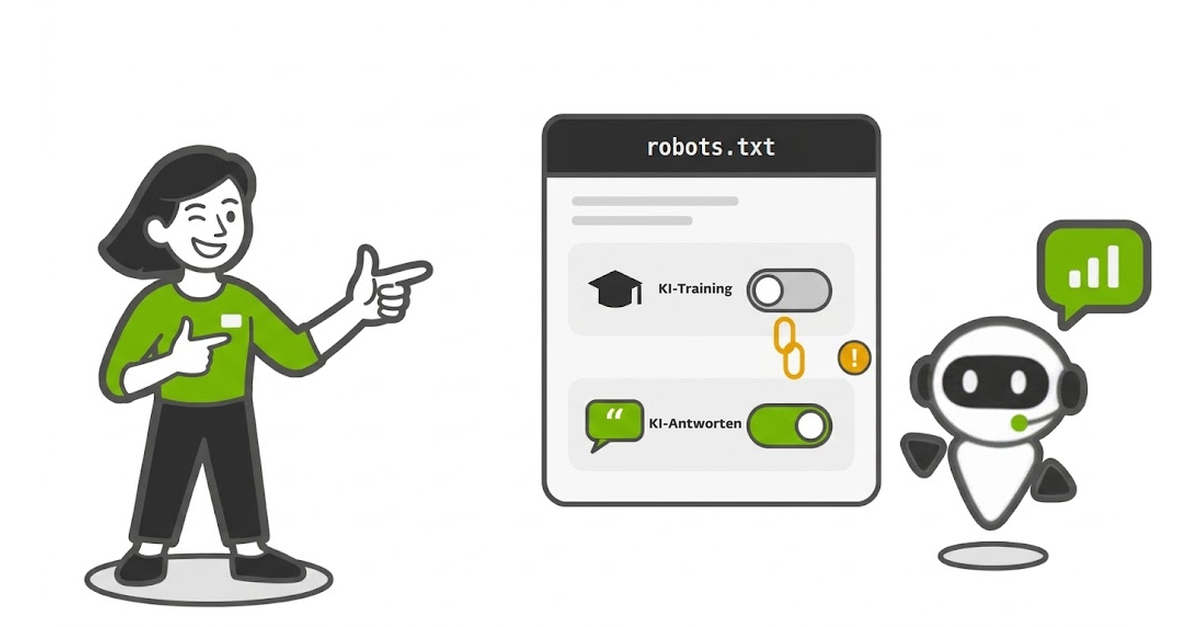
Beim Training fließen Inhalte in künftige Modelle ein und prägen, was ein Modell über eine Marke, ein Produkt oder ein Thema „weiß“. Beim Grounding ruft ein KI-System eine Seite live ab, um eine aktuelle Frage zu beantworten, und nennt sie dabei als Quelle. Genau das ist die Sichtbarkeit, um die es bei KI-Suche geht.
Ein Opt-out vom Training betrifft also künftige Modelle. Ob eine Seite heute in einer KI-Antwort zitiert wird, hängt dagegen vom Grounding ab. Entscheidend ist, ob sich beides getrennt steuern lässt.
Was die Anbieter umsetzen
Microsoft trennt beides: Training und Grounding lassen sich unabhängig voneinander steuern, auch für einzelne Seiten. Bisher galten bei Bing die Angaben NoArchive und NoCache auch als KI-Präferenz. Ab dem 1. März 2027 ist das nicht mehr der Fall, wer sie dafür nutzt, muss umstellen.
Google koppelt beides für Gemini: Training und die Nutzung in der Gemini-App hängen bislang an derselben Einstellung. Wer das Training blockiert, kann damit auch aus den Antworten der Gemini-App fallen. Für die AI Overviews und den AI Mode gibt es eine eigene Einstellung in der Google Search Console. Die Unterstützung des gemeinsamen Signals ist für Anfang 2027 angekündigt.
OpenAI und Anthropic wollen das gemeinsame Training-Signal ebenfalls respektieren.
Was B2B-Unternehmen jetzt tun sollten
Für Industrieunternehmen, die in KI-Antworten gefunden werden wollen, gilt: erst entscheiden, dann blockieren.
- Bestandsaufnahme: Welche KI-Crawler erlaubt oder sperrt Ihre robots.txt heute, etwa GPTBot, Google-Extended, ClaudeBot oder PerplexityBot? Viele Sperren wurden irgendwann pauschal gesetzt und nie überprüft.
- Meta-Angaben prüfen: Nutzt Ihre Website NoArchive oder NoCache? Dann ändert sich bei Bing zum 1. März 2027 die Wirkung.
- Bewusst entscheiden: Für die meisten B2B-Unternehmen, die von KI-Empfehlungen profitieren wollen, überwiegt der Nutzen der Sichtbarkeit.
- Wirkung messen: Ob Ihre Inhalte in KI-Antworten zitiert werden, zeigt eine Citation-Analyse, vor und nach jeder Änderung.
Wie Sie Ihre Website technisch für KI-Systeme vorbereiten, etwa mit einer llms.txt, zeigt unser Beitrag TYPO3 agent-ready machen.
Sie sind unsicher, was Ihre Website den KI-Crawlern heute signalisiert?
➡️ Mehr zu AEO & GEO
➡️ Citation-Analyse mit aiva
Fragen zu robots.txt und KI-Crawlern?
➡️ Sprechen Sie uns an
Stand: November 2026.
Quellen: Microsoft Bing Blog, Google Search Central Blog, OpenAI, Search Engine Journal