Bloquer l'entraînement de l'IA sans disparaître des réponses de l'IA
L'opt-out IA commun et ses conséquences sur la visibilité
Le 30 octobre 2026, OpenAI, Google, Microsoft et Anthropic ont annoncé qu'ils prendraient en charge un signal commun dans le robots.txt. Il doit permettre aux éditeurs de sites d'exclure leurs contenus de l'entraînement de l'IA auprès des quatre fournisseurs en une seule étape, au lieu de devoir bloquer un robot distinct pour chacun d'eux. Il repose sur un projet déposé à l'IETF, et sa mise en œuvre se poursuivra jusqu'en 2027.
Pour mieux contrôler ses propres contenus, c'est un progrès. Pour la visibilité dans les réponses de l'IA, il cache toutefois un piège qu'il vaut mieux connaître.
Entraînement et grounding : deux choses différentes
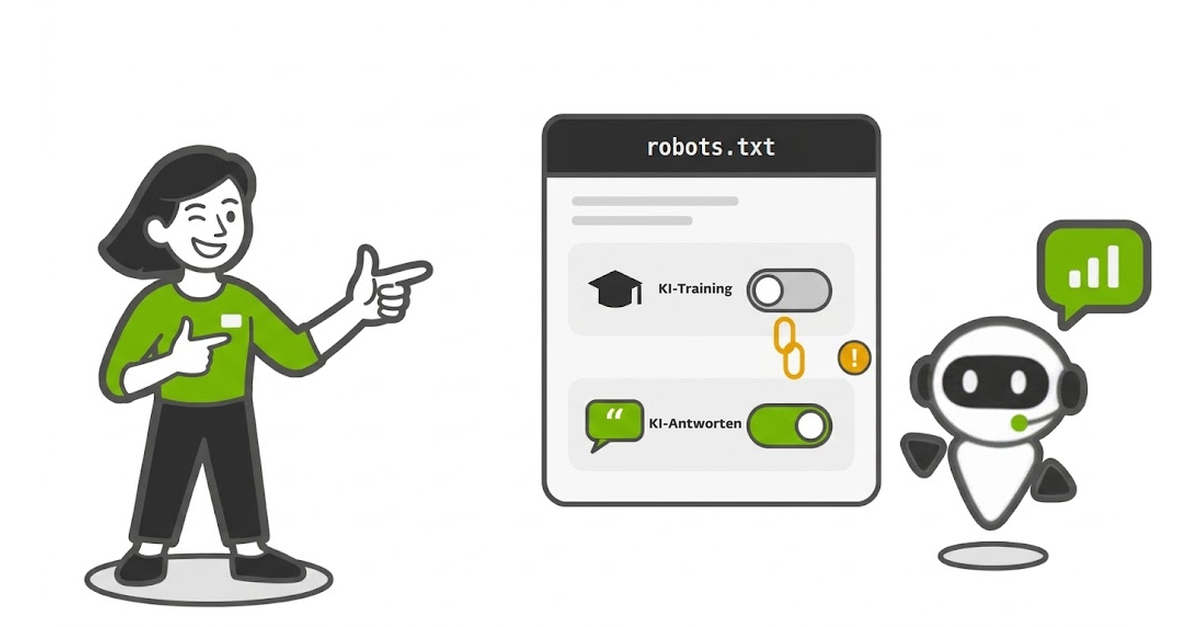
Lors de l'entraînement, les contenus alimentent les futurs modèles et façonnent ce qu'un modèle « sait » d'une marque, d'un produit ou d'un sujet. Avec le grounding, un système d'IA consulte une page en direct pour répondre à une question actuelle et la cite comme source. C'est précisément cette visibilité qui compte dans la recherche par IA.
Un opt-out de l'entraînement concerne donc les futurs modèles. Qu'une page soit citée aujourd'hui dans une réponse de l'IA dépend en revanche du grounding. L'essentiel est de savoir si les deux peuvent être contrôlés séparément.
Ce que mettent en œuvre les fournisseurs
Microsoft sépare les deux : l'entraînement et le grounding peuvent être contrôlés indépendamment l'un de l'autre, y compris pour des pages individuelles. Jusqu'à présent, Bing considérait aussi les directives NoArchive et NoCache comme des préférences IA. À partir du 1er mars 2027, ce ne sera plus le cas : ceux qui les utilisent à cette fin devront changer de méthode.
Google lie les deux pour Gemini : l'entraînement et l'utilisation dans l'application Gemini dépendent pour l'instant du même paramètre. Bloquer l'entraînement peut donc aussi faire disparaître un site des réponses de l'application Gemini. Les AI Overviews et l'AI Mode disposent de leur propre paramètre dans la Google Search Console. La prise en charge du signal commun est annoncée pour début 2027.
OpenAI et Anthropic entendent également respecter le signal commun relatif à l'entraînement.
Ce que les entreprises B2B doivent faire dès maintenant
Pour les entreprises industrielles qui veulent être trouvées dans les réponses de l'IA, la règle est simple : décider d'abord, bloquer ensuite.
- Faire l'inventaire : quels robots d'IA votre robots.txt autorise-t-il ou bloque-t-il aujourd'hui, par exemple GPTBot, Google-Extended, ClaudeBot ou PerplexityBot ? De nombreux blocages ont été mis en place de manière générale à un moment donné et n'ont jamais été réexaminés.
- Vérifier les métadonnées : votre site utilise-t-il NoArchive ou NoCache ? Leur effet sur Bing changera alors au 1er mars 2027.
- Décider en connaissance de cause : pour la plupart des entreprises B2B qui veulent profiter des recommandations de l'IA, l'intérêt de la visibilité l'emporte.
- Mesurer l'impact : une analyse des citations montre si vos contenus sont cités dans les réponses de l'IA, avant et après chaque modification.
Comment préparer techniquement votre site pour les systèmes d'IA, par exemple avec un fichier llms.txt, c'est ce que montre notre article Rendre TYPO3 agent-ready.
Vous ne savez pas ce que votre site signale aujourd'hui aux robots d'IA ?
➡️ En savoir plus sur l'AEO & le GEO
➡️ Analyse des citations avec aiva
Des questions sur le robots.txt et les robots d'IA ?
➡️ Contactez-nous
Situation en novembre 2026.
Sources : Microsoft Bing Blog, Google Search Central Blog, OpenAI, Search Engine Journal